


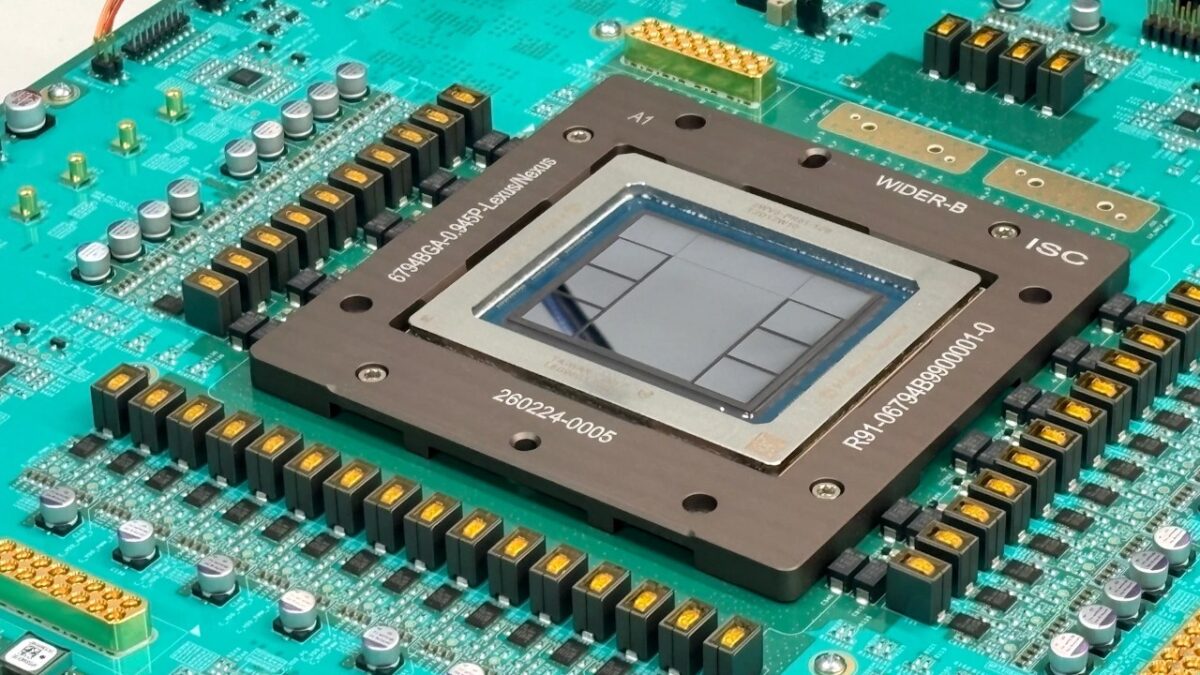
Jalapeño проектировала OpenAI в сотрудничестве с Broadcom. Сам чип компания представила ещё 24 июня 2026 года, но тогда ограничилась предварительными оценками. Опубликованные 25 августа результаты стали первой подробной демонстрацией работы реального кремния на нескольких крупных языковых моделях.
Что показал Jalapeño в первых тестах
OpenAI проверила Jalapeño с помощью InferenceX — публичного набора тестов SemiAnalysis для оценки систем инференса. Испытания проводились на трёх моделях разного происхождения: GPT-OSS 120B, DeepSeek R1 670B и Kimi K2.5 1T.
По данным OpenAI, во всех трёх случаях Jalapeño обеспечил лучшее сочетание пропускной способности, энергопотребления и задержки среди систем, выбранных компанией для сравнения.
| Модель | Система сравнения | Производительность на кВт | Сквозная задержка |
|---|---|---|---|
| GPT-OSS 120B | Nvidia GB200 | примерно в 1,9 раза выше | в 1,7 раза ниже |
| DeepSeek R1 670B | Nvidia GB300 | примерно в 1,7 раза выше | в 3,6 раза ниже |
| Kimi K2.5 1T | Nvidia GB300 | примерно в 1,5 раза выше | в 3,4 раза ниже |
На GPT-OSS 120B Jalapeño достиг 85 448 смешанных токенов в секунду на киловатт против 44 960 у системы на GB200. Сквозная задержка составила 1,03 секунды против 1,80 секунды.
С DeepSeek R1 результат составил 19 641 токен в секунду на киловатт против 11 781 у GB300. Сквозная задержка снизилась с 5,99 до 1,65 секунды.
Для Kimi K2.5 OpenAI получила 18 195 токенов в секунду на киловатт против 11 862 у GB300, а задержку — 1,56 секунды против 5,31 секунды.
Jalapeño потребляет до 700 Вт
Номинальная мощность Jalapeño составляет 700 Вт. При этом OpenAI утверждает, что во время опубликованных тестов фактическое устойчивое энергопотребление чипа оставалось на уровне 550 Вт или ниже.
Для сравнения результатов компания использовала официальные показатели мощности самих ускорителей: 1200 Вт для GB200 и 1400 Вт для GB300.
Этот момент существенен для правильного прочтения результатов. Показатель «производительность на киловатт» в опубликованных графиках рассчитывается относительно номинальной мощности ускорителей, а не полного энергопотребления всего дата-центра или серверной стойки.
Поэтому цифры OpenAI показывают эффективность непосредственно вычислительной платформы в заданных условиях тестирования, но не являются готовым сравнением полной стоимости эксплуатации инфраструктуры.
Чип рассчитан прежде всего на быстрые ответы ИИ
Jalapeño создавался специально для инференса больших языковых моделей. Он не предназначен как универсальная замена GPU для всех видов вычислений.
Во время обработки запроса языковая модель проходит несколько разных этапов. Сначала система анализирует входной контекст, затем начинает последовательно генерировать токены ответа. Эти процессы предъявляют разные требования к вычислениям, памяти и обмену данными между чипами.
OpenAI утверждает, что Jalapeño проектировался так, чтобы уменьшить перемещение данных и задержки между вычислительными блоками. В частности, состояние модели и KV-кэш, используемый во время генерации ответа, можно удерживать ближе к нужным вычислительным ресурсам.
Для пользователя результат должен проявляться проще: меньшая задержка между запросом и ответом и более быстрая генерация при большом количестве одновременных обращений.
Это особенно заметно для ИИ-агентов, которые за одну задачу могут последовательно выполнить десятки или сотни обращений к модели. Даже небольшая задержка на каждом этапе в таком сценарии складывается в заметное время ожидания.
На интерактивных задачах преимущество оказалось ещё выше
OpenAI отдельно измеряла работу систем в режимах, где особенно важна скорость ответа одному пользователю.
В таких сценариях Jalapeño показал от 2,1 до 4,1 раза более высокую производительность по сравнению с системами, участвовавшими в тестировании.
Например, минимальное время между токенами для DeepSeek R1 составило 1,43 мс на Jalapeño против 5,90 мс на GB300. Это соответствует примерно 700 токенам в секунду на пользователя против 169 токенов в секунду.
На Kimi K2.5 показатели составили 1,44 мс против 5,48 мс.
Именно низкая задержка может оказаться одним из главных преимуществ специализированного ускорителя OpenAI. Современные ИИ-сервисы всё чаще переходят от обычного чат-бота к агентам, которым необходимо быстро выполнять множество последовательных действий.
Но сравнение с Nvidia требует оговорки
Результаты выглядят сильными для первого поколения собственного чипа, однако напрямую утверждать, что Jalapeño «быстрее всех чипов Nvidia», было бы неправильно.
В тестах OpenAI использовались системы семейства Blackwell — GB200 и GB300. Новейшая архитектура Nvidia Vera Rubin в опубликованное сравнение не вошла.
SemiAnalysis, чей тест InferenceX использовала OpenAI, отдельно обращает внимание на это ограничение. Аналитики считают более актуальным будущим конкурентом Jalapeño именно поколение Rubin, поскольку массовое развёртывание собственного ускорителя OpenAI начнётся позже.
Есть и второе ограничение. Опубликованные испытания использовали контролируемую нагрузку с контекстом 8 тысяч токенов и генерацией 1 тысячи токенов. Более сложные AgentX-тесты с длинным контекстом и многократным взаимодействием агентов для Jalapeño пока не опубликованы.
SemiAnalysis сообщает, что специалисты компании видели работу Jalapeño и проверяли запуски InferenceX непосредственно в лаборатории OpenAI. При этом полный набор тестов они самостоятельно не выполняли, а исходные показатели для опубликованного сравнения предоставила OpenAI.
Поэтому результаты уже значительно содержательнее обычных маркетинговых оценок, но независимым полномасштабным тестированием их пока считать нельзя.
Jalapeño разработали вместе с Broadcom
Название «собственный чип OpenAI» не означает, что компания создала всю производственную цепочку самостоятельно.
OpenAI отвечает за архитектуру ускорителя и её адаптацию под реальные нагрузки своих моделей. Broadcom участвует в реализации кремния и сетевой части, а Celestica помогает с платами, стойками и системной интеграцией.
При первоначальном анонсе OpenAI сообщала, что от начала проектирования до tape-out — передачи финального проекта для производства — команда дошла за девять месяцев. Компания связывает такую скорость в том числе с использованием собственных ИИ-моделей в разработке.
OpenAI использовала ИИ для перебора вариантов реализации, проверки конструкции и оптимизации отдельных арифметических блоков.
После появления рабочего кремния модели начали помогать уже с программированием самого ускорителя.
OpenAI использовала свои модели для программирования Jalapeño
Компания сообщает, что с помощью собственных ИИ-систем инженеры смогли быстрее адаптировать Jalapeño под новые модели, которые изначально не входили в производственный план чипа.
На отдельных блоках attention и mixture-of-experts для GPT-OSS автоматически сгенерированные реализации оказались в 1,5–1,8 раза быстрее существующих вариантов, написанных специалистами вручную.
OpenAI отдельно подчёркивает, что этот результат относится к выбранным вычислительным блокам, а не к производительности всей модели.
Получается замкнутый цикл: модели OpenAI помогают проектировать и программировать оборудование, а новое оборудование затем используется для ускорения следующих поколений моделей.
Зачем OpenAI собственный чип
Основные расходы крупных ИИ-компаний всё сильнее связаны с вычислительной инфраструктурой.
После обучения модели необходимо постоянно обрабатывать запросы пользователей. Для сервисов масштаба ChatGPT, API и Codex даже небольшое снижение стоимости одного ответа может дать заметную экономию при миллиардах операций.
Jalapeño проектировался вокруг именно таких нагрузок OpenAI, а не как универсальный ускоритель, который должен одинаково хорошо выполнять любые вычислительные задачи.
Компания рассчитывает одновременно увеличить количество запросов, обрабатываемых при том же энергопотреблении, и сократить задержку ответа.
При этом OpenAI не собирается полностью переходить на собственные чипы.
Компания прямо заявляет, что продолжит массово использовать ускорители Nvidia и других партнёров для обучения и инференса. Jalapeño станет дополнительной вычислительной платформой для тех задач, где специализированная архитектура OpenAI оказывается выгоднее.
Первые Jalapeño начнут устанавливать до конца 2026 года
OpenAI планирует начать развёртывание Jalapeño в собственной вычислительной инфраструктуре до конца 2026 года. Сейчас компания продолжает производственную квалификацию чипа, дорабатывает программное обеспечение и проверяет его на дополнительных моделях.
Первым поколением программа не ограничится.
OpenAI сообщила, что Jalapeño Gen 2 уже находится на глубокой стадии разработки, а архитектура Gen 3 начинает формироваться. Компания рассматривает собственные ускорители как многолетнюю аппаратную платформу.
Если опубликованные показатели сохранятся после перехода к массовому использованию, Jalapeño даст OpenAI возможность часть наиболее дорогого инференса перенести на оборудование, созданное непосредственно под ChatGPT, Codex, API и будущих ИИ-агентов.
Первые тесты уже показывают, что проект дошёл дальше экспериментального образца: OpenAI располагает работающим кремнием, запускает на нём крупные модели и публикует измеряемые результаты. Следующим показателем станет работа Jalapeño в реальной инфраструктуре компании под продолжительной пользовательской нагрузкой.


